Kodėl Google neindeksuoja mano puslapių?
Dažniausia priežastis nėra bausmė ir ne algoritmo paslaptis. Puslapis arba techniškai neprieinamas Googlebot'ui, arba pats prašo jo neindeksuoti (`noindex`, `canonical` į kitą adresą), arba Google jį rado, perskaitė ir nusprendė, kad jis nepridedą nieko naujo prie to, kas indekse jau yra.
Pirmas žingsnis visada tas pats: nustatyti, kurioje stadijoje puslapis sustojo. Search Console tam turi tikslius žodžius, ir jie reiškia labai skirtingus dalykus.
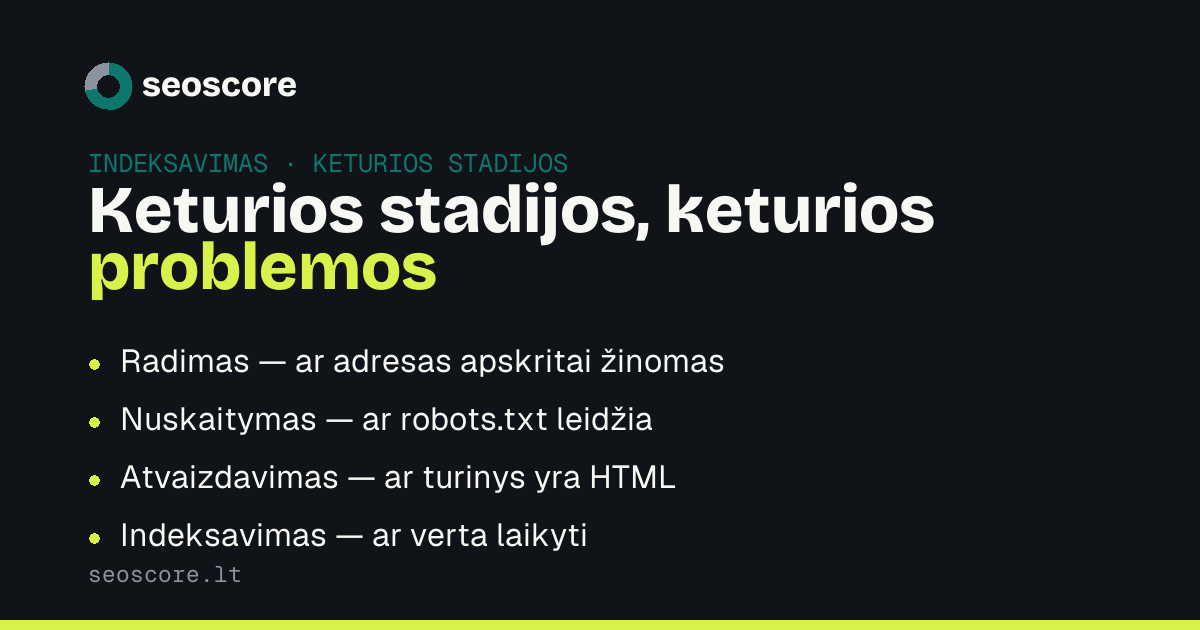
Keturios stadijos, keturios skirtingos problemos
„Discovered – currently not indexed" — Google žino adresą, bet dar neatėjo. Dažniausiai tai crawl biudžeto klausimas: svetainėje daug adresų, o šitas neatrodo svarbus. Padeda vidinės nuorodos iš puslapių, kurie jau indeksuoti.
„Crawled – currently not indexed" — atėjo, perskaitė, nepridėjo. Tai turinio sprendimas: puslapis atrodo per plonas arba per panašus į kitą tos pačios svetainės puslapį. Techniškai viskas gerai, todėl techniniai pataisymai čia nepadės.
„Excluded by 'noindex' tag" — puslapis pats prašo. Patikrink <meta name="robots"> ir X-Robots-Tag antraštę: dažnai noindex lieka nuo
kūrimo etapo arba jį prideda šablonas, kurio niekas neskaitė.
„Blocked by robots.txt" — botas net neįleistas. Svarbu suprasti, kad tai
ne tas pats, kas noindex: uždraudus crawl'ą Google puslapio turinio
nemato, bet patį adresą vis tiek gali parodyti rezultatuose be aprašymo.
Klaida, kurią daro dauguma
Puslapis vienu metu turi Disallow: /puslapis robots faile ir noindex
antraštę. Atrodo kaip dviguba apsauga — realiai tai vienas kitą naikinantys
nurodymai.
Uždraudus crawl'ą botas noindex niekada neperskaito, nes į puslapį
neužeina. Rezultatas: adresas kabo indekse be aprašymo, o savininkas
įsitikinęs, kad jo ten nėra.
Teisingas kelias yra vienas: nori, kad puslapio nebūtų indekse — leisk
crawl'ą ir palik noindex.
Ką patikrinti per penkias minutes
- Atidaryk puslapį inkognito lange — ar jis apskritai atsidaro be prisijungimo.
- Pažiūrėk HTML: ar nėra
<meta name="robots" content="noindex">. - Patikrink
canonical— jei jis rodo į kitą adresą, Google indeksuos tą, o ne šitą. - Atsidaryk
/robots.txtir ieškokDisallow, kuris apima šitą kelią. - Search Console → URL Inspection → „Test live URL". Jis pasako tiksliai, ką Googlebot mato dabar, o ne prieš mėnesį.
Kai visa tai tvarkinga
Tada problema yra turinys arba svarba. Puslapis, kuris kartoja tai, kas jau yra kitame tavo puslapyje, konkuruoja su juo pačiu — Google pasirenka vieną. Puslapis, į kurį neveda nė viena vidinė nuoroda, atrodo kaip pamirštas.
Nemokamas skenas parodo pirmus keturis punktus visiems puslapiams iš
karto: kurie grąžina ne 200, kurie turi noindex, kurių canonical rodo
kitur ir kuriuos blokuoja robots.txt.
Susiję straipsniai
Ta pati tema iš kitos pusės — kiekvienas atsako į savo klausimą:
- Discovered – currently not indexed: ką daryti
- Puslapių kanibalizacija: kaip ją pastebėti
- Kodėl svetainė lėta ir nuo ko pradėti
Kaip šitas dalykas patenka į balą, aprašyta ties ką tikriname.
Šaltiniai
Tai, kuo remiasi šis tekstas — pirminiai šaltiniai, ne perpasakojimai:
Dažni klausimai
Per kiek laiko Google indeksuoja naują puslapį?
Nuo kelių valandų iki kelių savaičių. Greitį lemia ne amžius, o tai, kaip dažnai Google apskritai lankosi svetainėje ir ar į naują puslapį veda nuorodos. Sitemap pagreitina radimą, bet indeksavimo negarantuoja.
Ar sitemap priverčia indeksuoti?
Ne. Sitemap yra pasiūlymas, kuriuos adresus verta aplankyti — sprendimą Google priima pats. Puslapis su `noindex` sitemap'e tik prieštarauja pats sau.
Ką daryti su „Crawled – currently not indexed"?
Techninių pataisymų čia nereikia, nes techniškai viskas gerai. Reikia priežasties, kodėl tas puslapis turi egzistuoti: originalaus turinio, savo duomenų, atsakymo, kurio kitur nėra. Jei tokios priežasties nėra, dažnai teisingiau puslapį sujungti su kitu.
Ar `noindex` pašalina puslapį iš indekso?
Taip, bet ne iš karto: Google turi vėl užeiti ir tą antraštę pamatyti. Būtent todėl uždrausti crawl'ą tuo pačiu metu yra klaida — taip pašalinimas niekada neįvyksta.
Pasitikrink
Nemokamas skenas parodo, ką iš to, kas aprašyta, tavo svetainė jau daro, o ko — ne.